Excel normalize(正規化)是將不同量級的數據統一到相同尺度的前置處理步驟,常用 Min-Max(縮放至 0~1)與 Z-Score(平均值 0、標準差 1)兩種方法。 本文完整教學兩種方法的公式操作、STANDARDIZE 函數語法、3 種職場應用範例,並附方法選擇速查表與常見錯誤排查。
正規化 vs 標準化:概念釐清與方法選擇
在處理 Excel 資料時,「正規化」和「標準化」經常被混用,但它們在數據處理上有明確的技術差異。搞清楚這兩個概念,才能在實務中選對方法。
正規化(Normalization / Min-Max Scaling) 是將數據線性縮放到一個固定範圍(通常是 0~1)。公式的核心邏輯是:每個值減去最小值,再除以全距。結果一定落在你指定的區間內,最小值變成 0,最大值變成 1。
標準化(Standardization / Z-Score Normalization) 則是將數據轉換為「距離平均值幾個標準差」的分數。轉換後的資料平均值為 0、標準差為 1,但數值沒有固定的上下限,可能出現正值或負值。
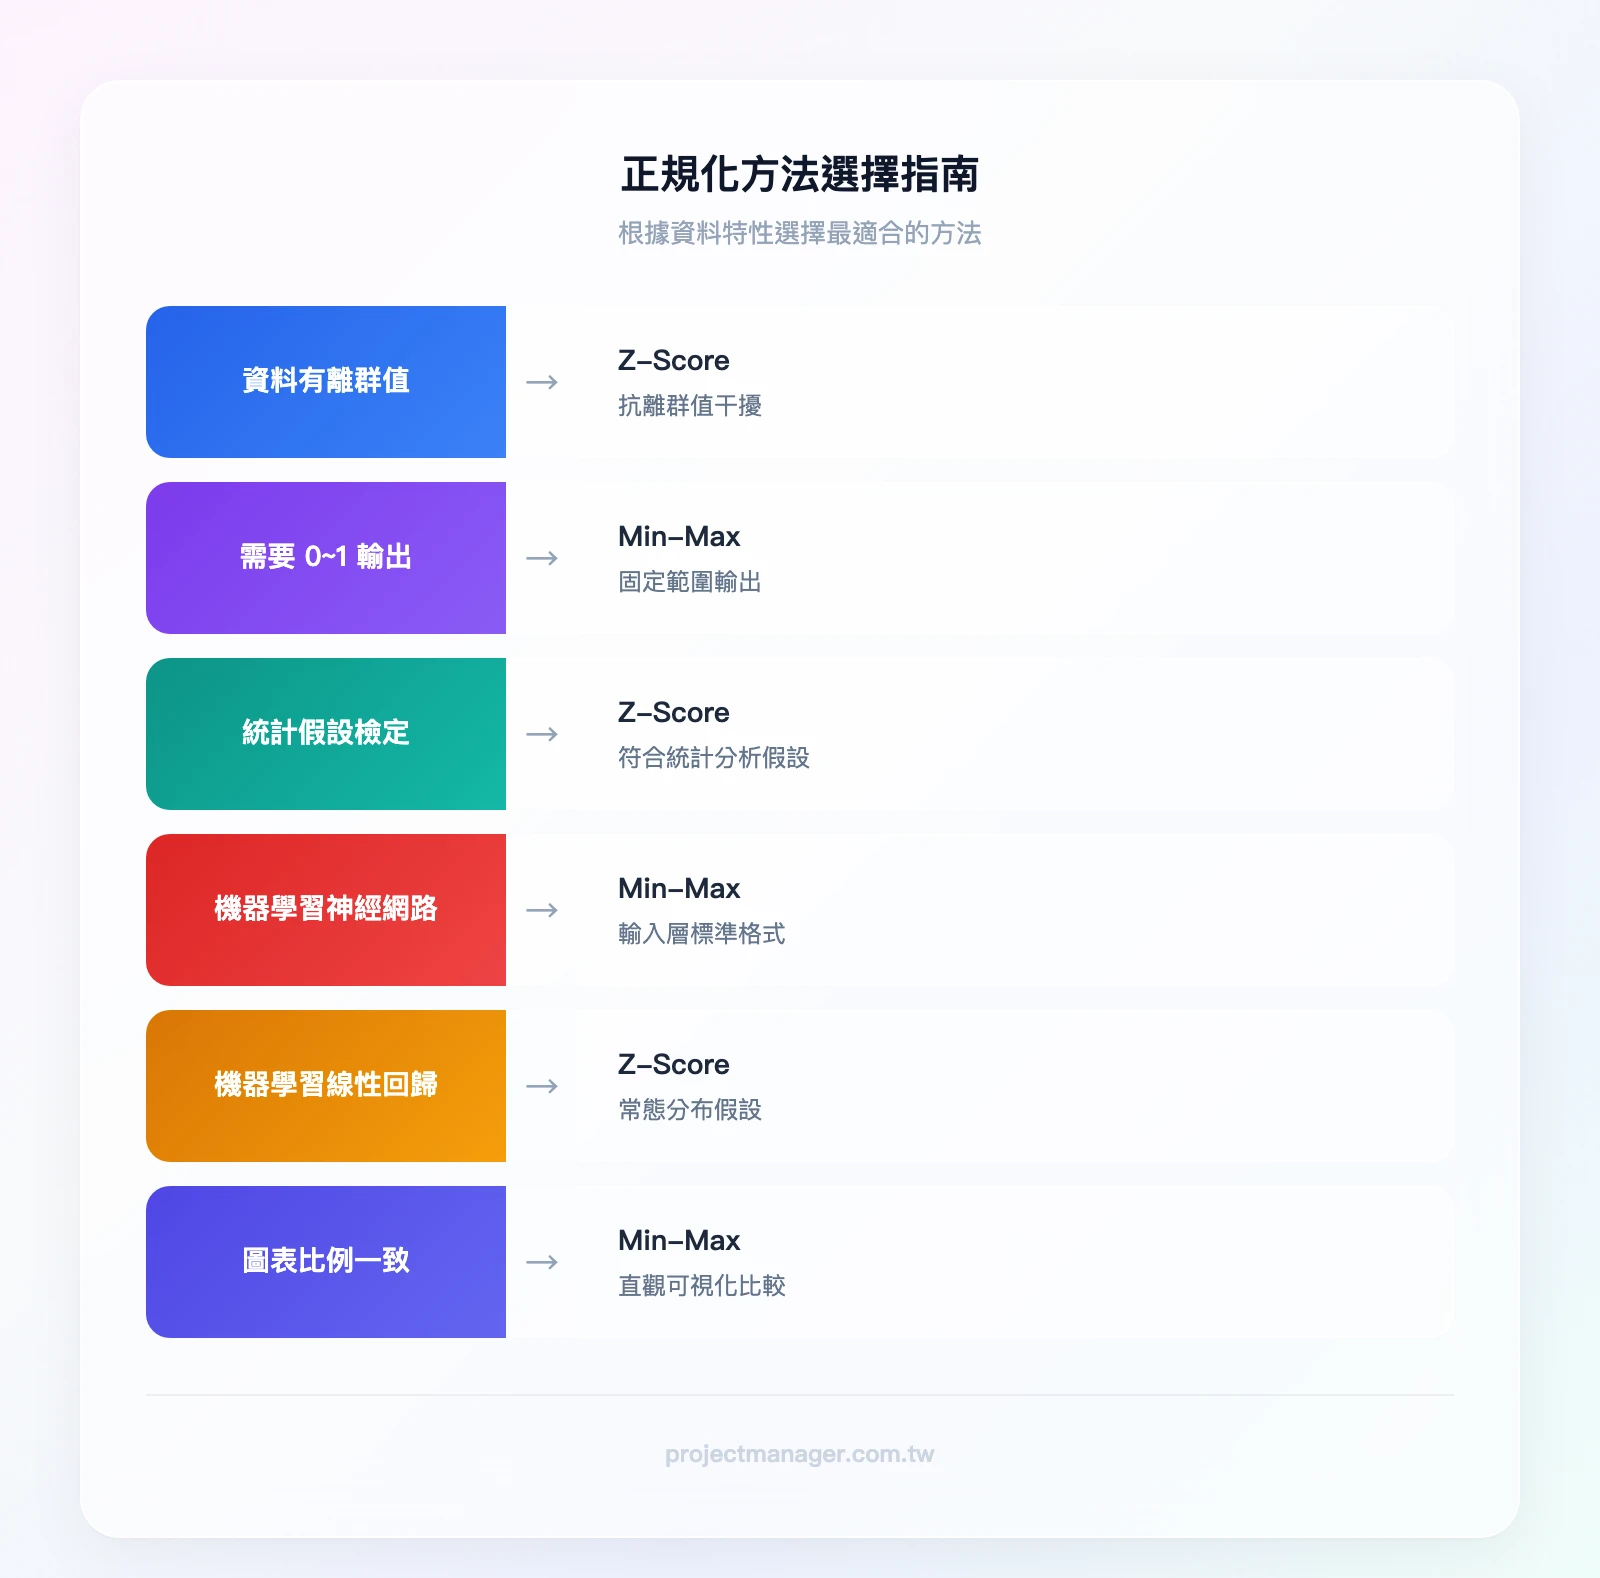
以下是兩種方法的完整比較,包含判斷條件幫助你快速選擇:
| 比較項目 | Min-Max 正規化 | Z-Score 標準化 |
|---|---|---|
| 英文術語 | Min-Max Scaling / Normalize | Z-Score Normalization / Standardize |
| 公式 | (x – min) / (max – min) |
(x – 平均值) / 標準差 |
| 輸出範圍 | 固定(預設 0~1) | 無固定範圍(通常 -3~+3) |
| 優點 | 直觀易理解、輸出範圍可控 | 抗離群值、適合統計分析 |
| 侷限 | 對異常值極度敏感 | 結果有正負值,較抽象 |
| 判斷條件:有離群值 | ❌ 不建議 | ✅ 優先選擇 |
| 判斷條件:需要 0~1 輸出 | ✅ 首選 | ❌ 無法保證範圍 |
| 判斷條件:統計假設檢定 | ❌ 不適用 | ✅ 首選 |
| 判斷條件:圖表比例一致 | ✅ 適合 | ⚠️ 可用但較複雜 |
| 判斷條件:機器學習輸入層 | ✅ 神經網路首選 | ✅ 線性回歸首選 |
選錯方法的後果:一個績效比較的真實案例
假設你要比較 A 部門和 B 部門的績效。A 部門的客戶滿意度評分範圍是 0~100 分,B 部門的業績金額範圍是 0~1,000,000 元。
未正規化的結果: 直接計算平均值,B 部門的數字必然遠高於 A 部門(例如 B 平均 520,000 vs A 平均 72),但這完全不代表 B 部門表現更好——你只是在比較兩把不同刻度的尺。
Min-Max 正規化後: 兩組數據都被縮放到 0~1,A 部門平均 0.72、B 部門平均 0.52,這才是公平的比較基礎。
但如果 B 部門有一筆異常值(某月業績暴衝到 5,000,000),Min-Max 會把其他所有正常值壓縮到 0~0.2 的狹窄區間,大部分數據的差異被「吃掉」了。這時改用 Z-Score 標準化,異常值會得到一個極端的 Z 值(例如 +4.2),但其他數據之間的相對差異仍然清晰可辨。
Min-Max 正規化:公式、步驟與操作教學
Min-Max 正規化的公式是所有正規化方法中最直觀的:
公式: 標準化值 = (x – min) / (max – min)
- x:要轉換的原始數據值
- min:該欄位的最小值
- max:該欄位的最大值
- 結果:介於 0(原始最小值)到 1(原始最大值)之間
Excel 操作步驟(含 10 筆示範數據)
我們用以下 10 筆數據來示範:45, 62, 78, 55, 90, 33, 71, 88, 50, 67。
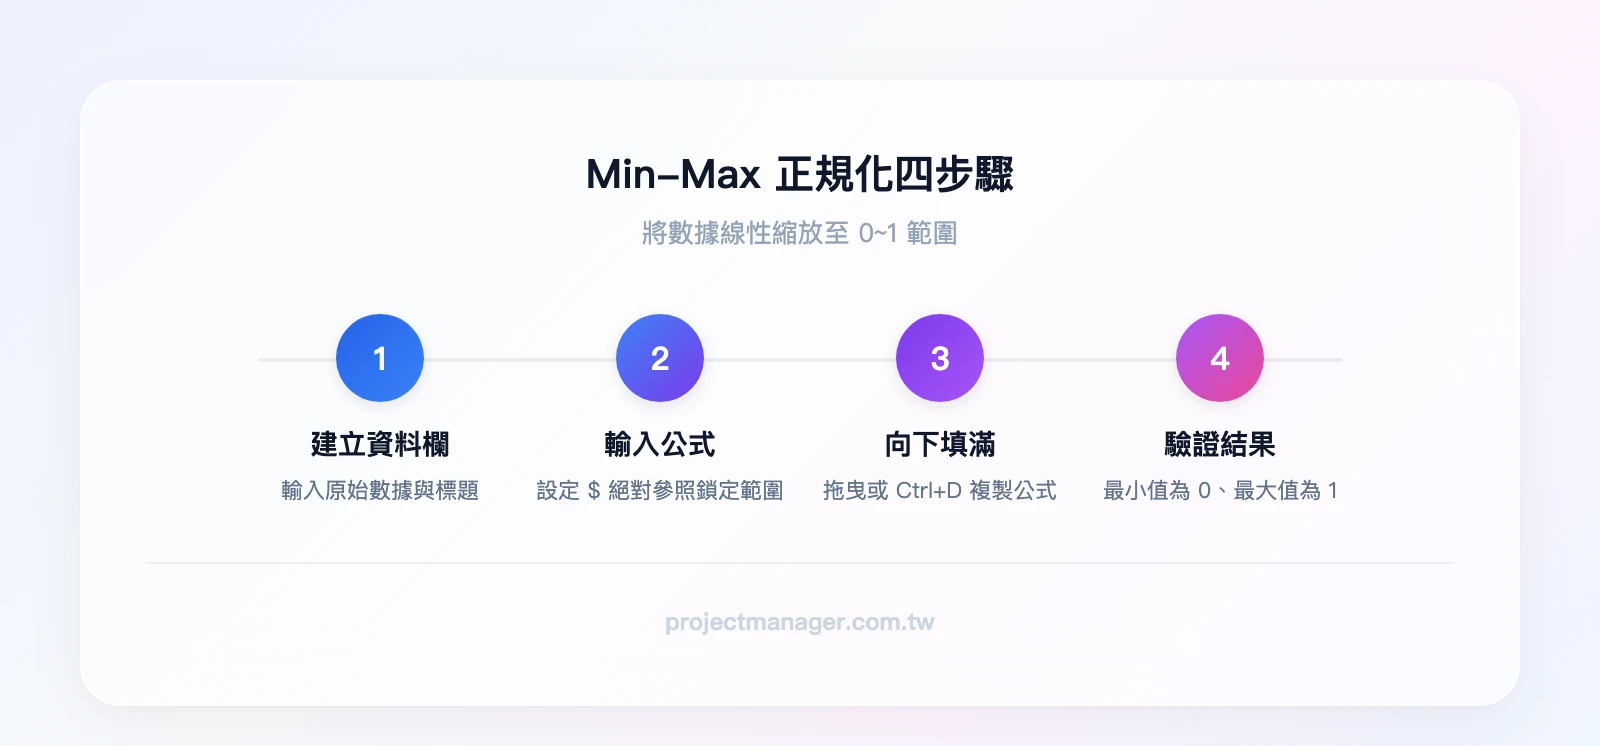
步驟 1:建立資料欄
在 A1 輸入標題「原始數據」,A2 到 A11 依序輸入 10 筆數值。在 B1 輸入標題「Min-Max 正規化」。
步驟 2:輸入公式並設定絕對參照
在 B2 輸入以下公式:
=(A2-MIN($A$2:$A$11))/(MAX($A$2:$A$11)-MIN($A$2:$A$11))
這裡用 $A$2:$A$11 的絕對參照(用 $ 鎖定欄列),是因為 MIN 和 MAX 必須始終參照整個資料範圍。如果用相對參照 A2:A11,當公式向下填滿時,範圍會跟著偏移,導致每一列計算的最小值和最大值都不同——結果完全錯誤。
步驟 3:向下填滿
選取 B2,將右下角的填滿控點向下拖曳到 B11,或使用快捷鍵 Ctrl+D。
步驟 4:驗證結果
檢查兩個關鍵值:
- 原始數據中的最小值 33(在 A7)→ B7 應為 0
- 原始數據中的最大值 90(在 A6)→ B6 應為 1
完整結果如下:
| 原始數據 | Min-Max 正規化 |
|---|---|
| 45 | 0.211 |
| 62 | 0.509 |
| 78 | 0.789 |
| 55 | 0.386 |
| 90 | 1.000 |
| 33 | 0.000 |
| 71 | 0.667 |
| 88 | 0.965 |
| 50 | 0.298 |
| 67 | 0.596 |
延伸應用:正規化到 0~1 以外的範圍
如果你需要將數據縮放到其他範圍(例如 -1 到 1,或 0 到 100),可以使用擴展公式:
公式: 標準化值 = (x – min) / (max – min) × (b – a) + a
其中 a 是目標範圍的下限,b 是目標範圍的上限。
例如,要將數據正規化到 -1 到 1 的範圍,Excel 公式為:
=(A2-MIN($A$2:$A$11))/(MAX($A$2:$A$11)-MIN($A$2:$A$11))*2-1
這個公式先做標準的 0~1 正規化,再乘以 2(將範圍擴展到 0~2),最後減 1(將範圍平移到 -1~1)。這在某些機器學習模型(如 tanh 激活函數)中特別實用。
常見錯誤排查
錯誤 1:#DIV/0!——最大值等於最小值
當所有數據值完全相同時,MAX - MIN = 0,分母為零。解法是用 IFERROR 包裹公式:
=IFERROR((A2-MIN($A$2:$A$11))/(MAX($A$2:$A$11)-MIN($A$2:$A$11)), 0)
這會在分母為零時回傳 0(或你指定的任何預設值)。
錯誤 2:異常值導致大多數結果集中在 0.1 以下
如果資料中有一筆極端值(例如其他值都在 30~90 之間,但有一筆是 5000),Min-Max 會把 5000 設為最大值,導致所有正常值被壓縮到極小的區間。
解法有兩種: 1. 先截尾再正規化:用四分位數(Q1 和 Q3)計算 IQR,將超出 Q3 + 1.5×IQR 的值視為離群值並排除 2. 改用 Z-Score:Z-Score 對離群值的敏感度遠低於 Min-Max
Z-Score 標準化:公式、步驟與操作教學
Z-Score 標準化將每個數據點轉換為「距離平均值幾個標準差」的分數:
公式: Z-Score = (x – 平均值) / 標準差
- x:要轉換的原始數據值
- 平均值:該欄位所有數據的算術平均
- 標準差:衡量數據分散程度的指標
- 結果:Z = 0 表示等於平均值,Z = +1 表示高於平均值一個標準差,Z = -2 表示低於平均值兩個標準差
手動公式操作步驟
使用同一組 10 筆示範數據(45, 62, 78, 55, 90, 33, 71, 88, 50, 67),方便與 Min-Max 結果對照。
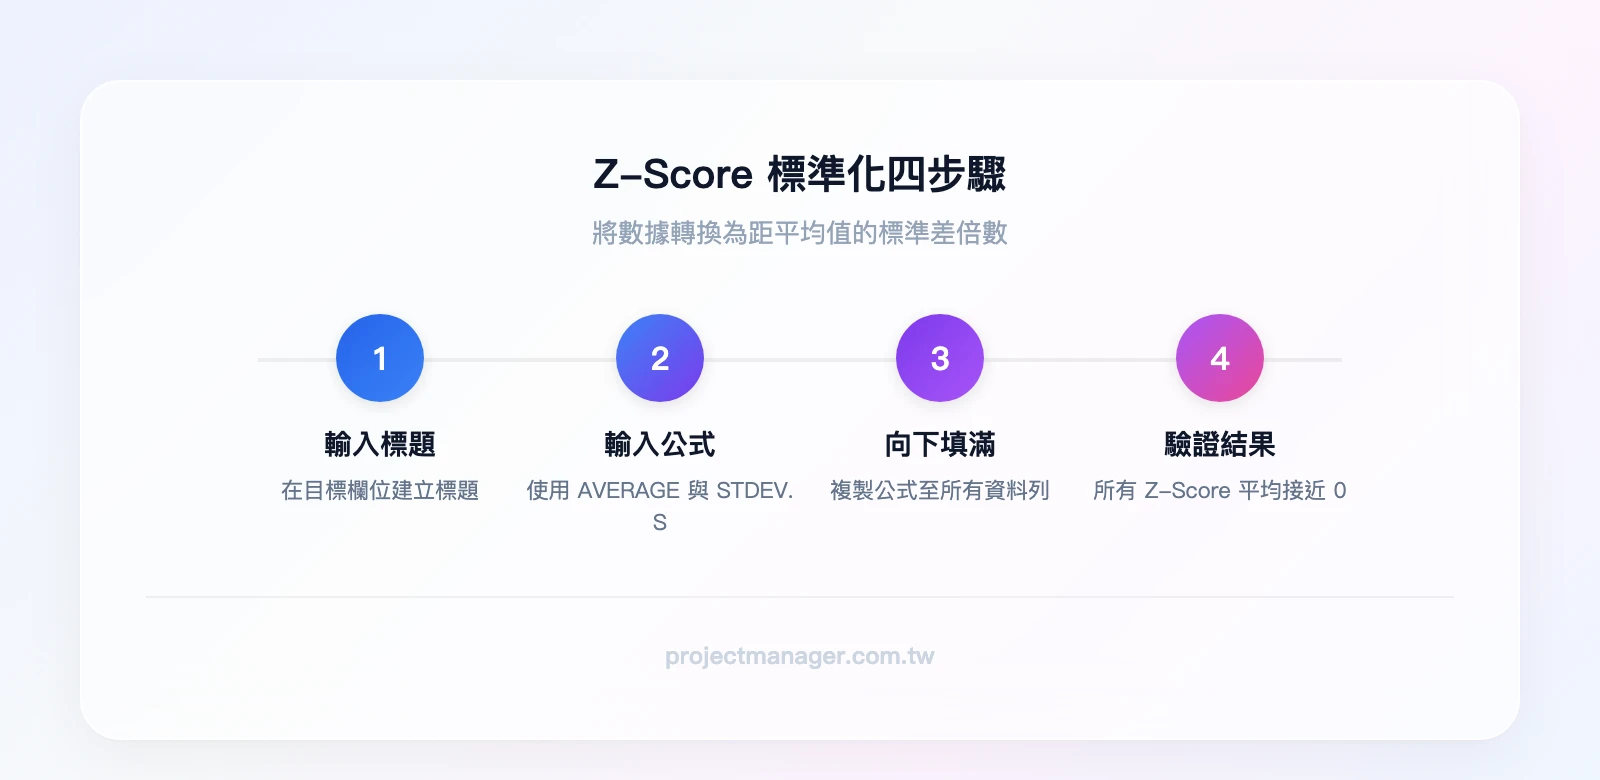
步驟 1: 在 C1 輸入標題「Z-Score」。
步驟 2: 在 C2 輸入公式:
=(A2-AVERAGE($A$2:$A$11))/STDEV.S($A$2:$A$11)
步驟 3: 向下填滿至 C11。
步驟 4: 驗證結果——所有 Z-Score 的平均值應接近 0(可用 =AVERAGE(C2:C11) 驗證)。
關於 STDEV.S 與 STDEV.P 的選擇:
STDEV.S(樣本標準差):你的資料只是母體的一部分樣本。例如:從全公司 500 人中抽取 50 人的績效數據。大多數實務場景用這個。STDEV.P(母體標準差):你的資料就是完整的母體。例如:全班 30 位學生的考試成績,你已經有所有人的分數。
如果不確定,選 STDEV.S 是比較保守(也比較安全)的做法。想深入了解兩者差異,可以參考Excel 標準差完整教學。
完整結果對照表:
| 原始數據 | Min-Max | Z-Score |
|---|---|---|
| 45 | 0.211 | -0.886 |
| 62 | 0.509 | 0.105 |
| 78 | 0.789 | 1.038 |
| 55 | 0.386 | -0.303 |
| 90 | 1.000 | 1.737 |
| 33 | 0.000 | -1.585 |
| 71 | 0.667 | 0.630 |
| 88 | 0.965 | 1.621 |
| 50 | 0.298 | -0.595 |
| 67 | 0.596 | 0.338 |
使用 STANDARDIZE 函數
Excel 內建的 STANDARDIZE 函數可以直接計算 Z-Score,不需要手動拆解公式。
語法: =STANDARDIZE(x, mean, standard_dev)
三個參數說明:
- x:要標準化的目標數值(例如 A2)
- mean:資料的平均值。可以輸入固定數字,也可以用
AVERAGE()動態計算 - standard_dev:資料的標準差。可以輸入固定數字,也可以用
STDEV.S()動態計算
完整範例:
=STANDARDIZE(A2, AVERAGE($A$2:$A$11), STDEV.S($A$2:$A$11))
這個公式的計算結果與手動公式 =(A2-AVERAGE($A$2:$A$11))/STDEV.S($A$2:$A$11) 完全相同。你可以在 D 欄輸入 STANDARDIZE 公式,然後用 =C2-D2 逐列比對,差值都會是 0(或極小的浮點誤差)。
何時用 STANDARDIZE 比手動公式更好?
當你需要跨工作表引用固定的統計值時。例如,你在「統計摘要」工作表中已經算好了平均值(儲存格 B2)和標準差(儲存格 B3),在「原始資料」工作表中就可以寫:
=STANDARDIZE(A2, 統計摘要!B2, 統計摘要!B3)
這比手動公式中嵌入跨工作表的 AVERAGE 和 STDEV.S 更簡潔、更容易維護。
常見錯誤排查
錯誤 1:#DIV/0!——標準差為 0
所有數據值相同時,標準差為 0,分母為零。解法同樣用 IFERROR:
=IFERROR(STANDARDIZE(A2, AVERAGE($A$2:$A$11), STDEV.S($A$2:$A$11)), 0)
錯誤 2:#VALUE!——欄位含文字或空白
如果資料欄中混入了文字(例如「N/A」、「待確認」)或非數值格式的數字,STANDARDIZE 會回傳 #VALUE! 錯誤。
解法:
1. 先用 ISNUMBER() 篩選,只對數值進行標準化:
=IF(ISNUMBER(A2), STANDARDIZE(A2, AVERAGE($A$2:$A$11), STDEV.S($A$2:$A$11)), "非數值")
- 如果問題是數字被存成文字格式,參考Excel 文字轉數字教學先修正格式
注意:MIN 和 MAX 函數會自動忽略文字儲存格,但 AVERAGE 不會——它會把含文字的儲存格排除在計數之外,可能導致平均值計算基數不一致。確保資料乾淨是正規化的第一步。
實務應用:三種職場情境的完整操作範例
掌握公式之後,關鍵是知道在什麼情境下該用哪種方法。以下三個案例涵蓋最常見的職場需求。
情境一:HR 多維度績效評比
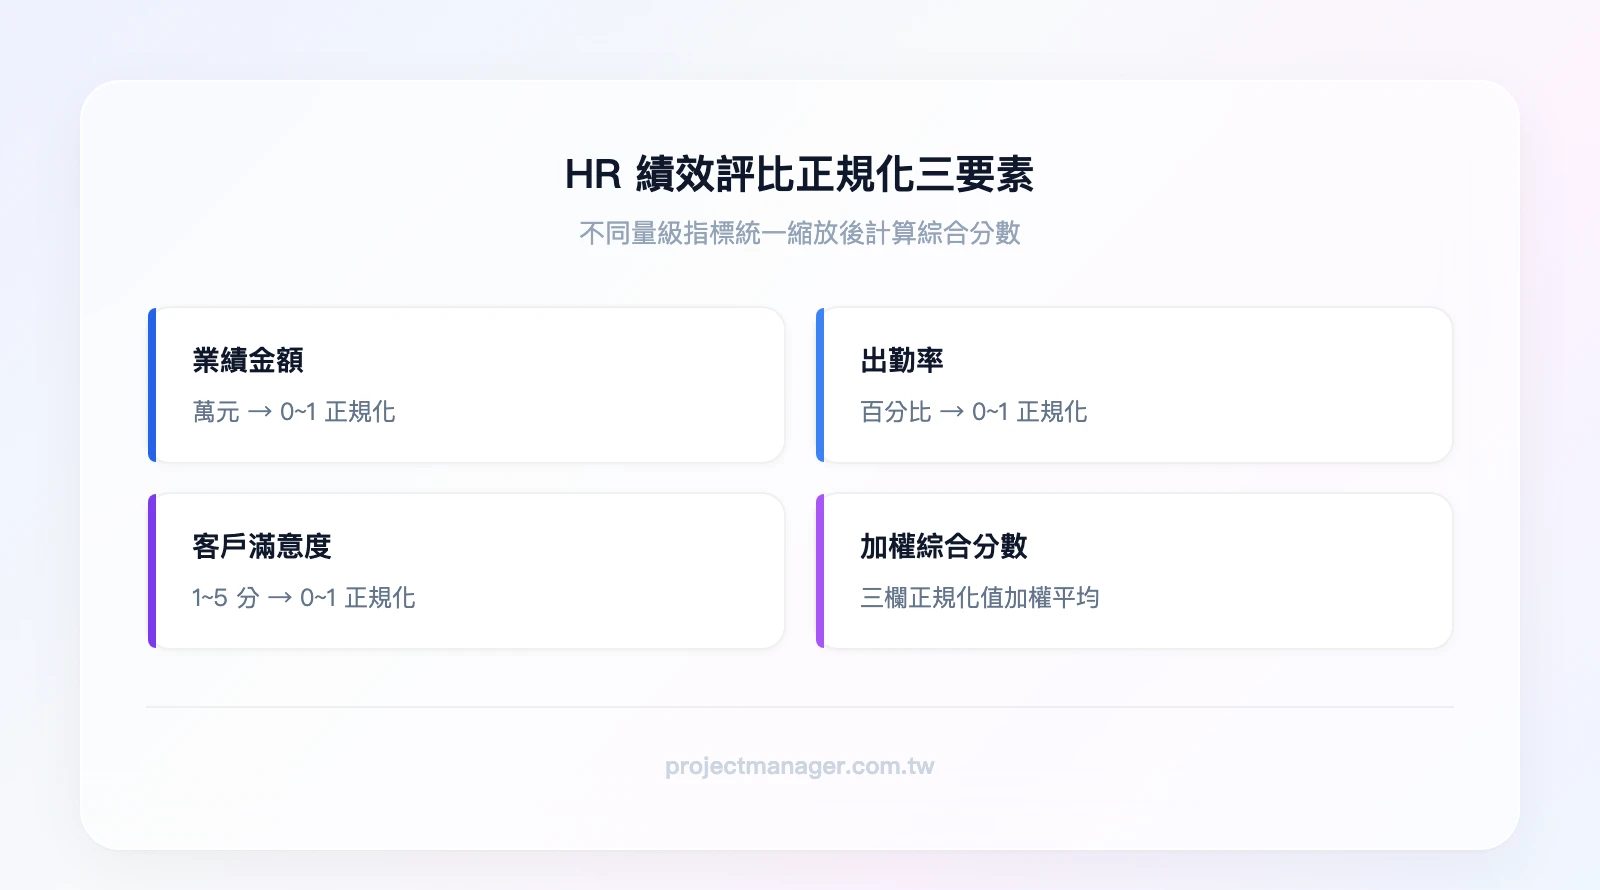
情境: 你是 HR,需要綜合評比三個部門的表現。評比維度有三項:業績金額(萬元)、出勤率(%)、客戶滿意度(1~5 分)。三項指標的單位和量級完全不同,無法直接加總。
操作方法: 對三欄分別做 Min-Max 正規化,再用 AVERAGE 計算綜合分數。
| 員工 | 業績(萬元) | 出勤率(%) | 客戶滿意度 | 業績正規化 | 出勤正規化 | 滿意度正規化 | 綜合分數 |
|---|---|---|---|---|---|---|---|
| 王小明 | 120 | 95 | 4.2 | 0.571 | 0.750 | 0.600 | 0.640 |
| 李小華 | 85 | 98 | 4.8 | 0.071 | 1.000 | 1.000 | 0.690 |
| 張大偉 | 190 | 88 | 3.5 | 1.000 | 0.167 | 0.133 | 0.433 |
| 陳美玲 | 78 | 92 | 4.5 | 0.000 | 0.500 | 0.800 | 0.433 |
| 林志豪 | 155 | 85 | 3.7 | 0.821 | 0.000 | 0.267 | 0.363 |
從結果可以看到,李小華雖然業績最低,但出勤和客戶滿意度都最高,綜合分數反而排名第一。如果只看業績金額,張大偉會是冠軍——但正規化後的綜合評比呈現了更全面的圖像。
你可以用 =AVERAGE(E2:G2) 計算綜合分數,也可以根據公司策略調整權重(例如業績佔 50%、出勤佔 20%、滿意度佔 30%),改用 =E2*0.5+F2*0.2+G2*0.3。搭配中位數可以進一步判斷分數分布是否偏態。
情境二:跨系統數據整合
情境: 你從 ERP 匯出了月銷售額(單位:萬元,範圍 50~500),又從 CRM 匯出了客戶評分(1~5 分)。主管要求你合併分析,找出「業績好且客戶滿意度高」的業務員。
為什麼不能直接加總? 銷售額 200 萬 + 客戶評分 4.5 = 204.5?這個數字毫無意義,因為銷售額的量級完全壓過了客戶評分。
操作步驟:
- 分別對銷售額欄和客戶評分欄做 Min-Max 正規化
- 兩欄正規化後的值都在 0~1 之間,可以直接相加或取平均
- 用
=AVERAGE(正規化銷售額, 正規化客戶評分)得到綜合指標,排序找出最佳業務員
情境三:機器學習前置處理
情境: 你在 Excel 中整理好了訓練資料(例如房價預測模型的特徵欄位:坪數、屋齡、距捷運站距離),準備匯出為 CSV 給 Python 或 R 建模。
方法選擇依據:
- 神經網路(Deep Learning):輸入層通常需要 0~1 的數值 → 用 Min-Max
- 線性回歸、邏輯回歸:假設特徵呈常態分布 → 用 Z-Score
- 決策樹、隨機森林:對數值尺度不敏感 → 通常不需要正規化
在 Excel 中完成正規化後匯出,比在 Python 中用 sklearn.preprocessing 更適合非工程背景的分析師——你可以直接在試算表中目視檢查每個欄位的轉換結果。更多Excel 公式的進階應用可以幫助你建立更完整的資料處理流程。
如果你的正規化後資料需要跨部門共享或定期更新,Excel 檔案的版本管理會是一大痛點——多人同時編輯容易衝突,公式被誤改也難以追蹤。這時可以考慮用 monday.com 建立自動化的數據流程,將正規化後的結果同步到看板上,團隊成員即時查看最新數據,不用再來回傳檔案。
進階技巧:動態陣列與自動化正規化
如果你使用 Excel 365 或較新版本的 Excel,可以利用動態陣列功能大幅簡化正規化操作。
用 LET 函數簡化正規化公式
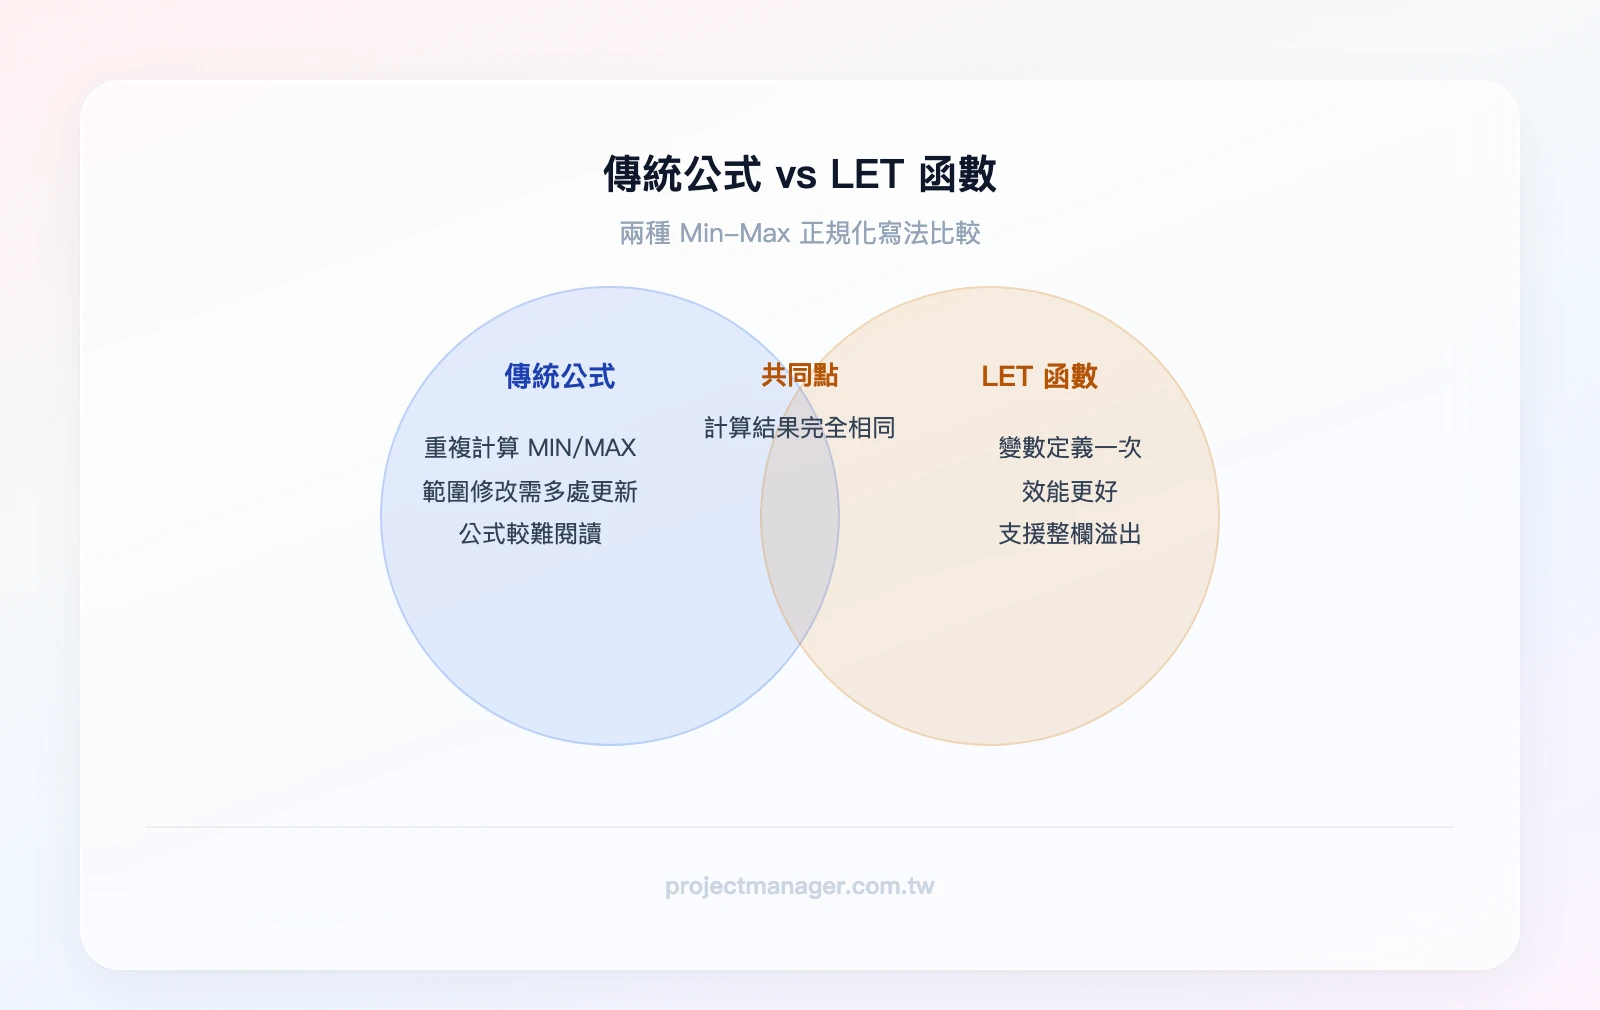
LET 函數允許你在公式內定義變數,避免重複計算 MIN 和 MAX。
傳統寫法(MIN 和 MAX 各計算兩次):
=(A2-MIN($A$2:$A$11))/(MAX($A$2:$A$11)-MIN($A$2:$A$11))
LET 寫法(MIN 和 MAX 各計算一次):
=LET(data, $A$2:$A$11, mn, MIN(data), mx, MAX(data), (A2-mn)/(mx-mn))
優點:
- 效能更好:大量資料時,避免重複計算可以明顯加速
- 可讀性更高:變數名稱讓公式意圖一目了然
- 維護更容易:如果資料範圍改變,只需修改
data一處
如果你的 Excel 版本支援溢出(Spill)功能,甚至可以一次正規化整欄:
=LET(data, A2:A11, mn, MIN(data), mx, MAX(data), (data-mn)/(mx-mn))
在 B2 輸入這個公式,結果會自動溢出到 B3:B11,不需要手動向下填滿。
處理含空白或文字的欄位
實務中的 Excel 資料很少是「乾淨」的。空白格、文字混入、格式錯誤都是常見問題。
用 ISNUMBER 過濾非數值:
=IF(ISNUMBER(A2), (A2-MIN($A$2:$A$11))/(MAX($A$2:$A$11)-MIN($A$2:$A$11)), "")
這個公式會先檢查 A2 是否為數值,是的話才進行正規化,否則回傳空白。
重要提醒: MIN 和 MAX 函數會自動忽略文字和空白儲存格,所以它們計算的最小值和最大值仍然是正確的。但 AVERAGE 的行為不同——它會跳過文字儲存格,但這會改變計算基數(分母變小),可能導致平均值偏高。
如果資料中有大量空白列需要先清理,可以參考 Excel 刪除空白列教學進行前置處理。
想更系統性地學習 Excel 資料處理與分析技巧,Coursera 上的 Excel 專業課程涵蓋從基礎到進階的完整內容,適合想提升數據分析能力的職場工作者。
方法選擇速查表與常見問題
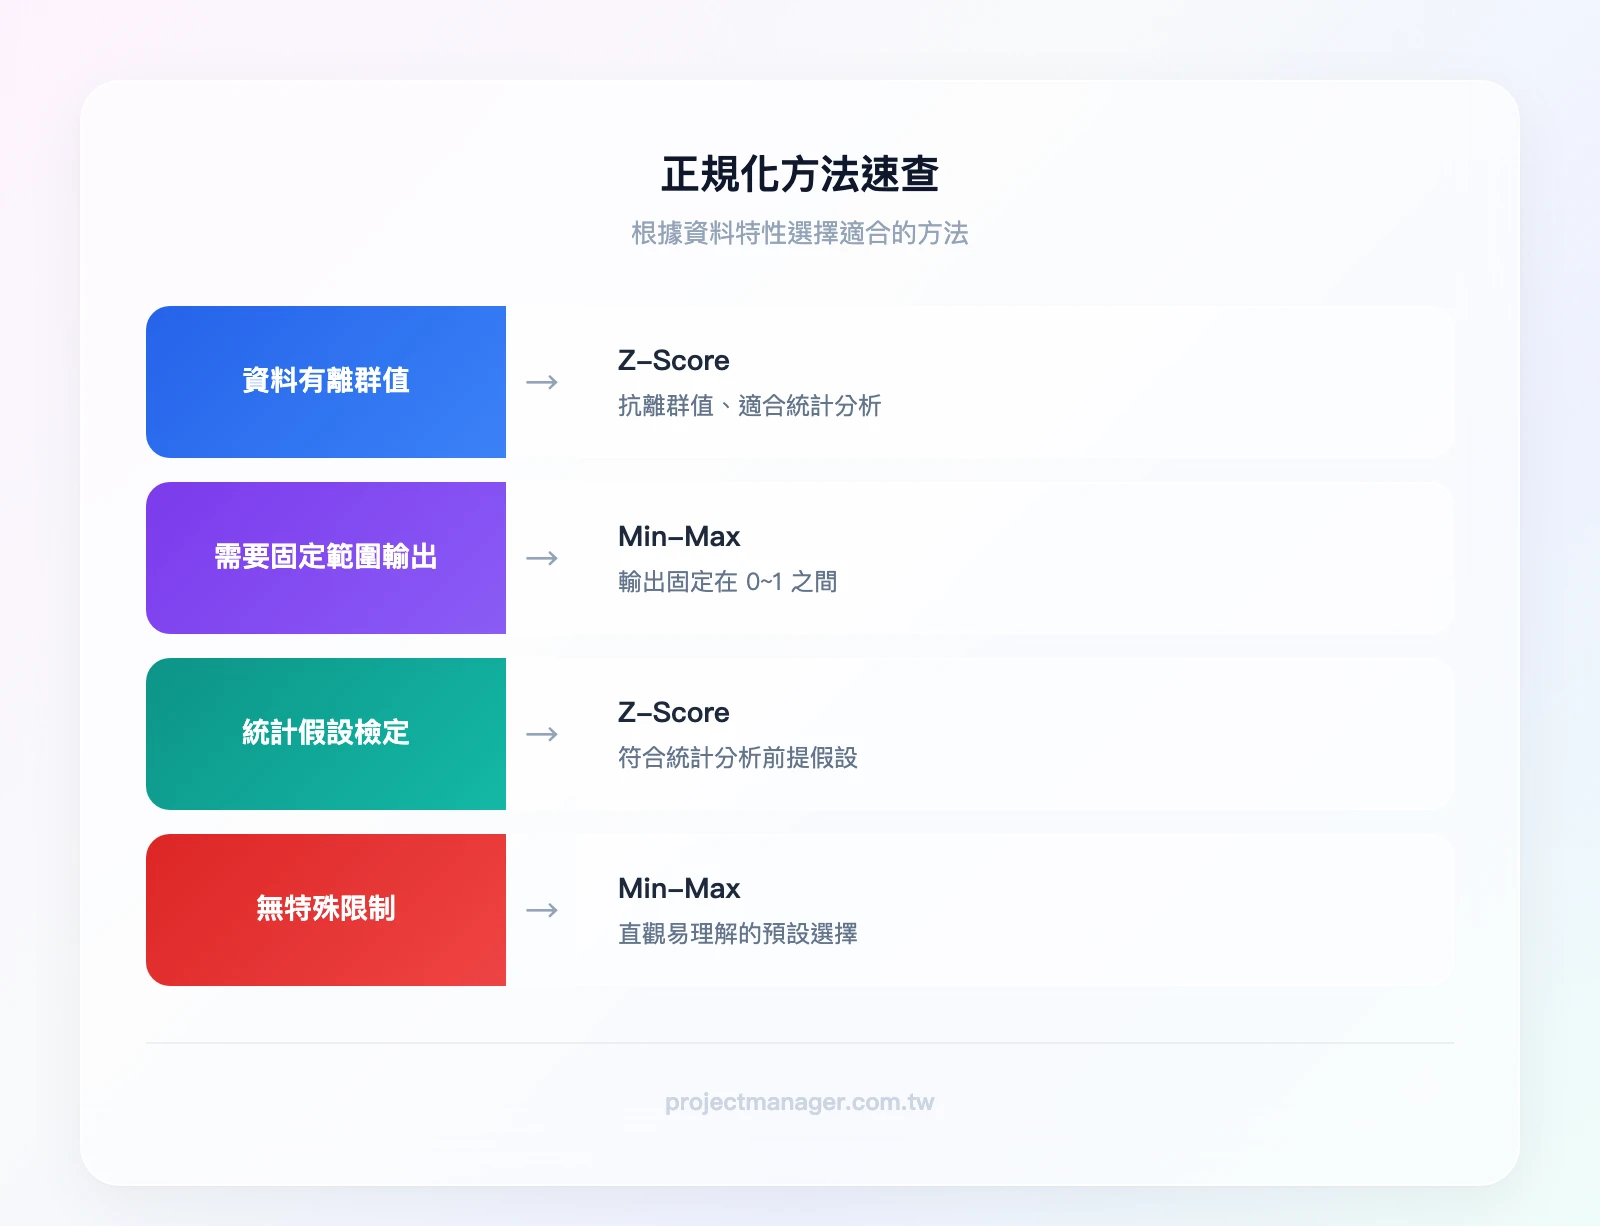
正規化方法速查表
| 情境 | 建議方法 | Excel 公式 |
|---|---|---|
| 需要 0~1 輸出 | Min-Max | =(x-MIN(範圍))/(MAX(範圍)-MIN(範圍)) |
| 資料有離群值 | Z-Score | =STANDARDIZE(x, AVERAGE(範圍), STDEV.S(範圍)) |
| 機器學習神經網路輸入 | Min-Max | =(x-MIN(範圍))/(MAX(範圍)-MIN(範圍)) |
| 統計假設檢定 | Z-Score | =STANDARDIZE(x, AVERAGE(範圍), STDEV.S(範圍)) |
| 跨部門績效比較 | 視情況 | 無離群值用 Min-Max,有離群值用 Z-Score |
| 需要 -1~1 輸出 | Min-Max 擴展 | =(x-MIN(範圍))/(MAX(範圍)-MIN(範圍))*2-1 |
Excel 有內建的 normalize 函數嗎?
沒有。Excel 沒有直接叫做 NORMALIZE 的函數。如果你需要 Z-Score 標準化,可以使用內建的 STANDARDIZE 函數;如果需要 Min-Max 正規化,則必須用手動公式 (x-MIN)/(MAX-MIN) 來實現。Google Sheets 同樣沒有 NORMALIZE 函數,但公式語法與 Excel 完全相同。
正規化後的數據可以還原嗎?
可以。只要你保留了原始的統計值,就能用反向公式還原:
- Min-Max 反向公式:
原始值 = 正規化值 × (max – min) + min - Z-Score 反向公式:
原始值 = Z-Score × 標準差 + 平均值
實務建議:正規化前,先在另一個儲存格記錄 MIN、MAX、AVERAGE、STDEV 的值,方便日後還原。你也可以用 Excel 絕對值函數 ABS 來輔助檢查還原後的誤差是否在可接受範圍內。
Google Sheets 的正規化公式和 Excel 一樣嗎?
公式語法完全相同。MIN、MAX、AVERAGE、STDEV 在 Google Sheets 中都可以直接使用。Google Sheets 的額外優勢是支援 ARRAYFORMULA,可以一次處理整欄:
=ARRAYFORMULA((A2:A11-MIN(A2:A11))/(MAX(A2:A11)-MIN(A2:A11)))
這等同於 Excel 365 的動態陣列溢出功能。
STDEV.S 和 STDEV.P 在正規化中該選哪個?
如果你的資料是從更大母體中抽取的樣本(這是大多數職場情境),用 STDEV.S。如果你的資料就是完整的母體(例如全班成績、全公司員工),用 STDEV.P。兩者的差異在於分母:STDEV.S 用 n-1(貝塞爾校正),STDEV.P 用 n。資料量越大,兩者差異越小。
結論
Excel normalize(正規化)是數據分析與專案管理中不可或缺的前置步驟。掌握正確的方法,能讓你的分析結果更可靠、決策更有依據。
本文重點回顧:
- Min-Max 正規化適合需要固定範圍輸出(0~1)且資料無明顯離群值的場景,公式為
(x-MIN)/(MAX-MIN) - Z-Score 標準化適合有離群值或需要統計分析的場景,可用手動公式或
STANDARDIZE函數 - 選擇方法的關鍵:先判斷資料是否有離群值、輸出是否需要固定範圍、後續分析方法是什麼
- 進階技巧:用
LET函數簡化公式、用ISNUMBER處理含文字的欄位、用IFERROR防止除以零錯誤 - 實務應用涵蓋 HR 績效評比、跨系統數據整合、機器學習前置處理三大場景
建議學習路徑: 先從 Min-Max 正規化開始練習(最直觀),熟悉後學習 Z-Score 與 STANDARDIZE 函數,最後嘗試 LET 動態陣列提升效率。更多 Excel 技巧可以參考我們的 Excel 教學指南。
如果你的正規化工作涉及跨部門協作——例如多個部門各自整理數據後需要合併分析——Excel 檔案的版本管理和即時同步會是持續的痛點。monday.com 的儀表板功能可以將各部門的關鍵數據集中呈現,設定自動化規則在數據更新時通知相關人員,免費方案不需要信用卡,10 分鐘就能建好你的第一個數據追蹤看板。