pd.read_excel 是 pandas 套件中讀取 Excel 檔案(.xls、.xlsx、.xlsm、.xlsb、.ods)並轉為 DataFrame 的核心函數。 本文完整解析 13 個核心參數、3 種安裝環境設定、中文亂碼排解方式,並附多部門報表合併的端對端實務案例與 6 種常見錯誤修復方法。
pd.read_excel 是什麼?適用情境與核心優勢
pd.read_excel 是 pandas 提供的函數,專門將 Excel 檔案中的表格資料讀入為 DataFrame 物件。一旦資料變成 DataFrame,你就能用 pandas 的全套功能進行篩選、統計、視覺化與自動化處理。
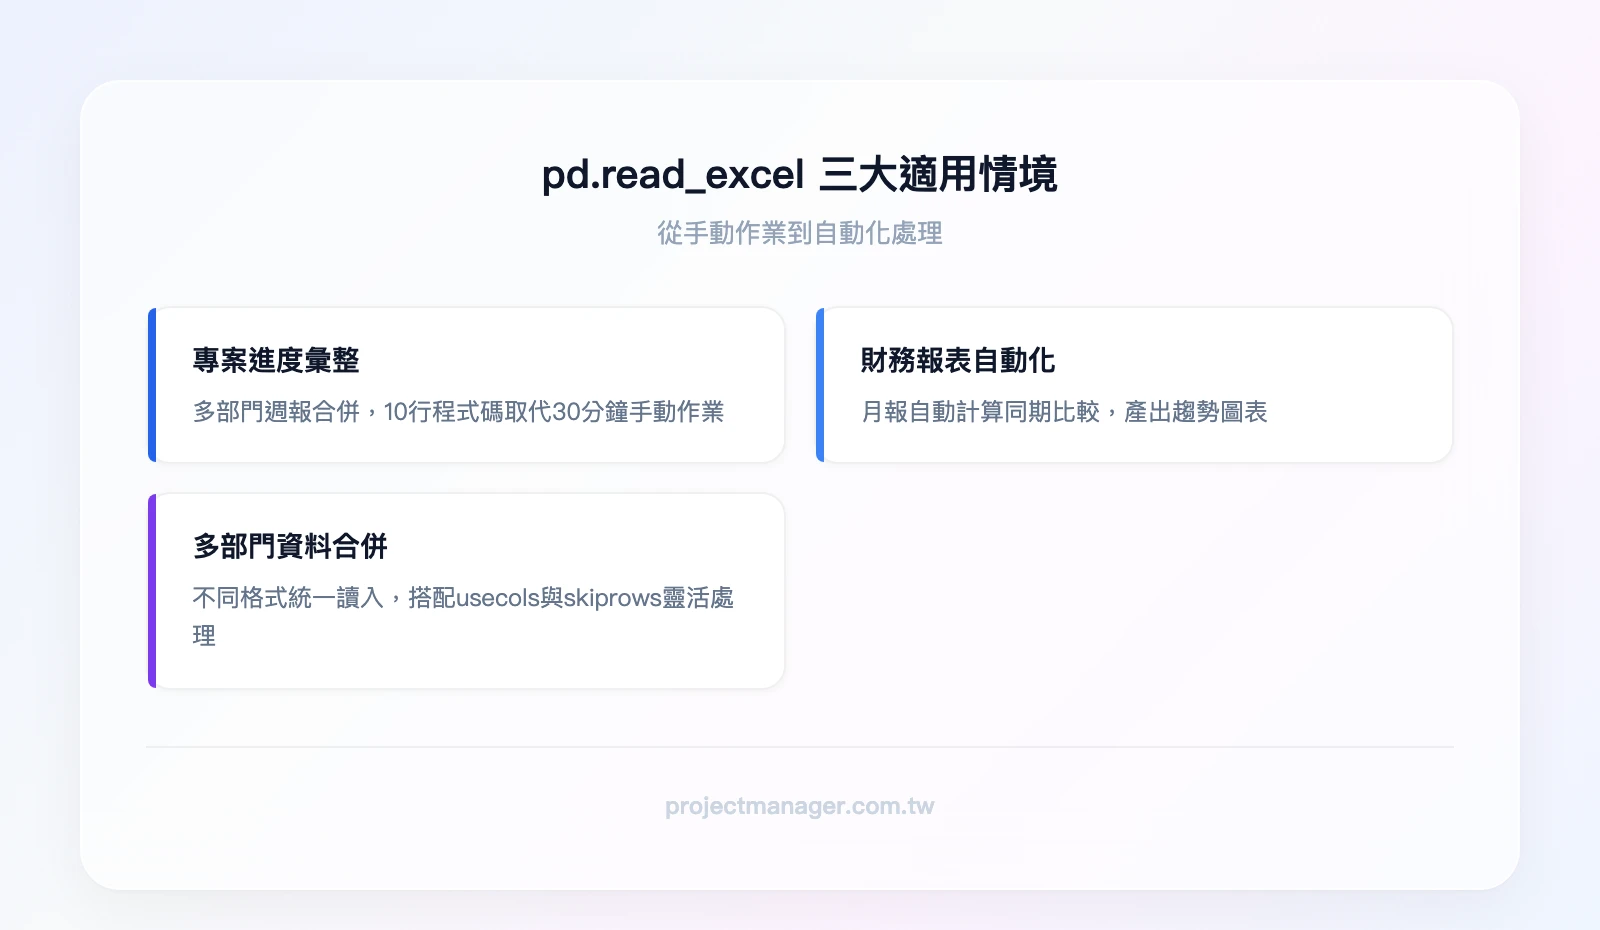
如果你還在用手動複製貼上的方式整理 Excel 報表,pd.read_excel 能幫你省下大量重複勞動。以下是台灣職場中三個最常見的使用情境:
情境一:專案進度彙整。 每週五各部門回傳進度 Excel,PM 需要合併成一份總表。手動做要花 30 分鐘以上,用 pd.read_excel 搭配 pd.concat 只需 10 行程式碼。
情境二:財務報表自動化。 會計部門每月產出的損益表、資產負債表都是 Excel 格式。用 pd.read_excel 讀入後,可以自動計算同期比較、產出趨勢圖表。
情境三:多部門資料合併。 業務、行銷、客服各有自己的 Excel 報表格式。pd.read_excel 的參數(usecols、skiprows、header)能靈活處理不同格式,統一讀入後再合併分析。
相較於手動操作,pd.read_excel 的核心優勢在於:可重複執行(寫一次程式碼,每次資料更新只需重跑)、精確控制(指定讀取哪些欄位、跳過哪些行)、以及與 pandas 生態系無縫整合(讀入後直接做 groupby、merge、pivot 等操作)。
想深入了解 Python 操作 Excel 的完整生態系,可以參考 Python 操作 Excel 教學,涵蓋讀取、寫入、格式控制等全方位內容。
支援的 Excel 格式與對應引擎
pd.read_excel 透過 engine 參數選擇不同的底層引擎來解析檔案。選錯引擎是新手最常遇到的錯誤來源之一。
| 格式 | 副檔名 | 對應引擎 | 建議 pandas 版本 | 備註 |
|---|---|---|---|---|
| Excel 97-2003 | .xls | xlrd | 所有版本 | xlrd 2.0+ 僅支援 .xls |
| Excel 2007+ | .xlsx, .xlsm | openpyxl | pandas 1.2+ | 最常用,建議預設安裝 |
| Excel 二進位 | .xlsb | pyxlsb | pandas 0.25+ | 大檔案常見格式 |
| OpenDocument | .ods | odf (odfpy) | pandas 0.25+ | LibreOffice 預設格式 |
關鍵變更提醒: pandas 1.2 開始,xlrd 不再支援 .xlsx 格式。如果你從舊版 pandas 升級,原本能正常執行的程式碼可能會突然報錯。解法是安裝 openpyxl 並明確指定 engine='openpyxl'。
前置需求:Python 版本與套件相容性
在開始之前,確認你的環境符合以下條件:
- Python 版本:3.9 以上(pandas 2.x 已不支援 Python 3.8)
- pandas 版本:建議 2.0 以上(語法穩定,效能更好)
- 必裝引擎:
openpyxl(讀取 .xlsx/.xlsm 的預設引擎)
pandas 2.x 的重要變更:
- 預設引擎從
xlrd改為openpyxl(針對 .xlsx) dtype_backend新增"numpy_nullable"和"pyarrow"選項date_parser參數已棄用,改用date_format
你可以用以下程式碼快速檢查環境:
import pandas as pd
import openpyxl

print(f"pandas 版本: {pd.__version__}")
print(f"openpyxl 版本: {openpyxl.__version__}")
安裝環境設定(pip / conda / Colab)
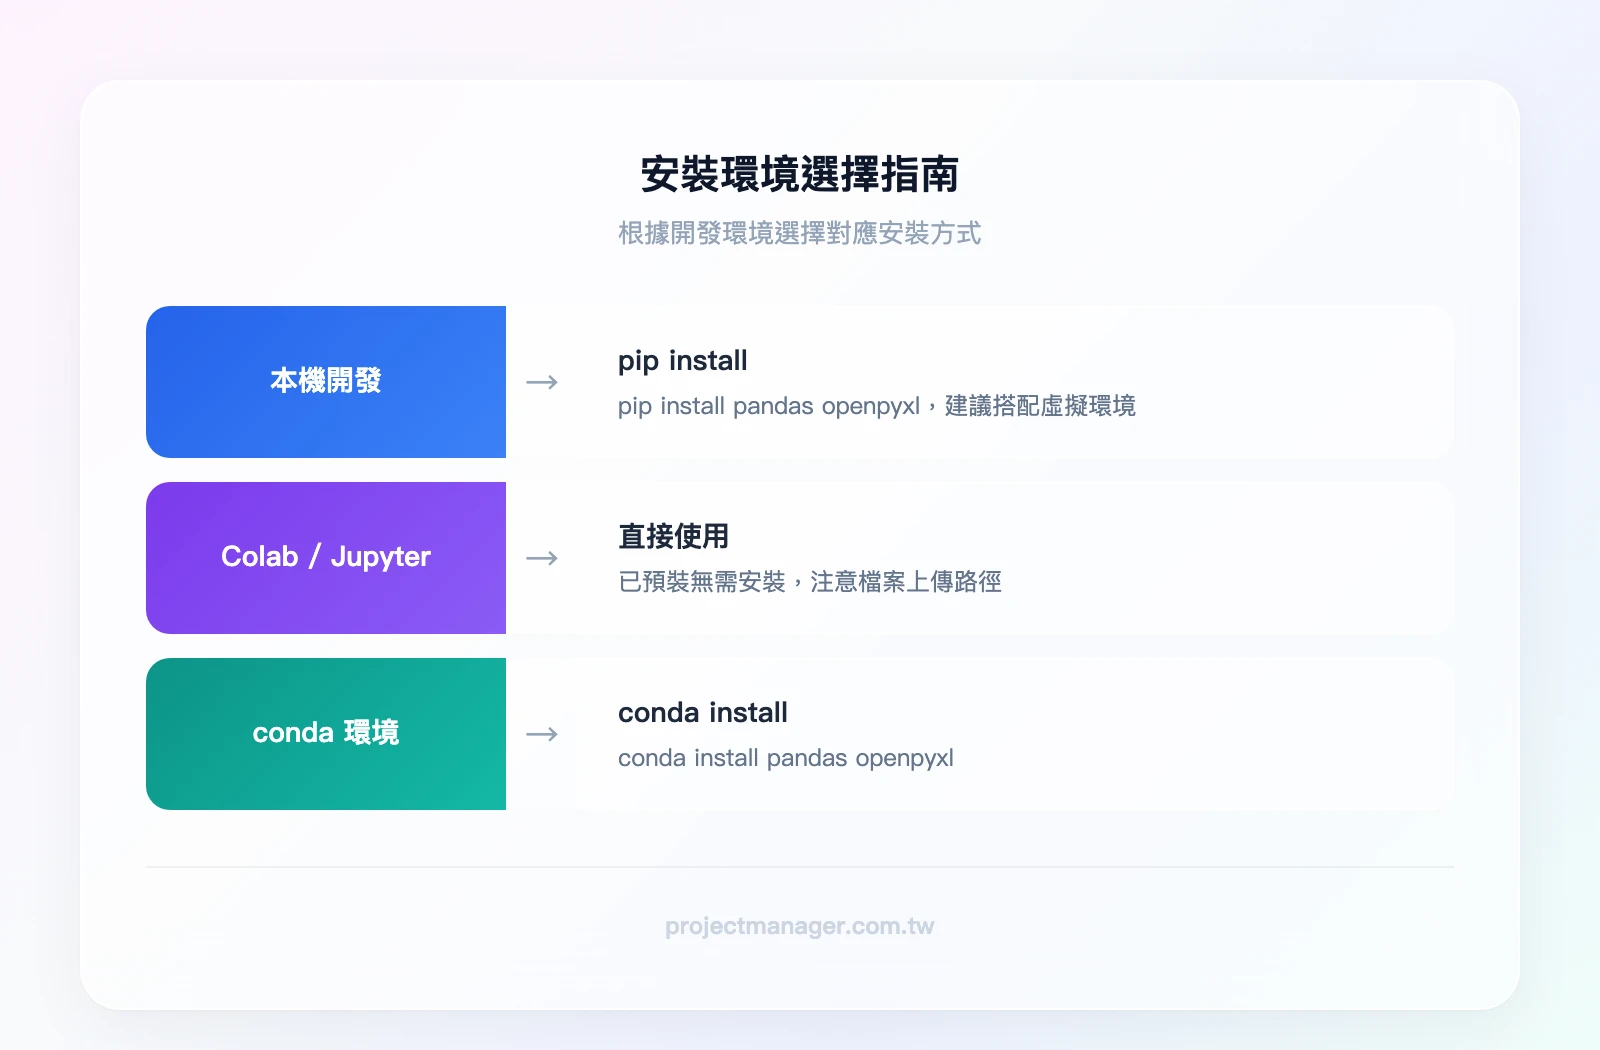
根據你的開發環境,安裝方式略有不同。以下涵蓋三種最常見的情境。
本機安裝(pip / conda 指令,含虛擬環境建立)
建議先建立虛擬環境,避免套件版本衝突影響其他專案:
## 建立虛擬環境
python -m venv excel_env

## 啟動虛擬環境(macOS / Linux)
source excel_env/bin/activate
安裝 pandas 與必要引擎:
## pip 安裝(最常用)
pip install pandas openpyxl

## 如果需要讀取 .xls 舊格式
pip install xlrd

## 如果需要讀取 .xlsb 二進位格式
pip install pyxlsb

## 如果需要讀取 .ods 格式
pip install odfpy
使用 conda 的話:
conda install pandas openpyxl
Google Colab 環境
Colab 已預裝 pandas 和 openpyxl,通常不需要額外安裝。但上傳檔案的方式與本機不同:
## 方法一:透過 Colab 上傳介面
from google.colab import files
uploaded = files.upload()  # 會跳出檔案選擇視窗

import pandas as pd
df = pd.read_excel('你的檔案名.xlsx')
## 方法二:從 Google Drive 讀取
from google.colab import drive
drive.mount('/content/drive')

df = pd.read_excel('/content/drive/MyDrive/data/report.xlsx')
如果 Colab 的 pandas 版本過舊,可以手動升級:
!pip install --upgrade pandas openpyxl
常見安裝錯誤排解
錯誤一:ImportError: Missing optional dependency 'openpyxl'
這是最常見的錯誤。pandas 讀取 .xlsx 時需要 openpyxl,但它不會隨 pandas 自動安裝。
pip install openpyxl
錯誤二:xlrd.biffh.XLRDError: Excel xlsx file; not supported
這表示你安裝了 xlrd 2.0+,但它已不支援 .xlsx。有兩種解法:
## 解法一(推薦):安裝 openpyxl 並指定引擎
pip install openpyxl
## 程式碼中加上 engine='openpyxl'
## 解法二(不推薦,僅臨時應急):降版 xlrd
pip install xlrd==1.2.0
錯誤三:Permission denied
## Windows 用管理員權限執行
pip install --user pandas openpyxl

## macOS / Linux
sudo pip install pandas openpyxl
錯誤四:版本衝突
如果出現套件版本衝突,最乾淨的解法是建立新的虛擬環境重新安裝。
基本語法與核心參數完整解析
這是 pd.read_excel 用法的核心章節。每個參數都附上「何時使用」的判斷說明,幫助你快速找到需要的功能。完整的 pandas read_excel 參數文件也值得收藏備查。
最基本的讀取方式
只需一行程式碼,就能將 Excel 第一個工作表讀入 DataFrame:
import pandas as pd

df = pd.read_excel('data.xlsx')
print(df.head())
預設行為:
- 讀取第一個工作表(
sheet_name=0) - 第一行作為欄位名稱(
header=0) - 自動偵測引擎(根據副檔名選擇 openpyxl 或 xlrd)
- 所有欄位都讀取
指定工作表(sheet_name)
Excel 檔案通常有多個工作表。sheet_name 參數支援多種指定方式:
## 以名稱指定
df = pd.read_excel('data.xlsx', sheet_name='任務列表')

## 以索引指定(0 為第一張表)
df = pd.read_excel('data.xlsx', sheet_name=1)

## 同時讀取多個工作表(回傳 dict)
dfs = pd.read_excel('data.xlsx', sheet_name=['任務列表', '預算表'])

## 讀取所有工作表(回傳 dict)
dfs = pd.read_excel('data.xlsx', sheet_name=None)
動態取得工作表名稱: 當你不確定檔案裡有哪些工作表時,可以用 pd.ExcelFile 先查看:
xls = pd.ExcelFile('data.xlsx')
print(xls.sheet_names)  # 輸出:['任務列表', '預算表', '人力配置']
工作表名稱含空白或特殊字元的處理: 直接用字串傳入即可,pandas 會正確處理。
## 工作表名稱有空白
df = pd.read_excel('data.xlsx', sheet_name='Q1 報表')

## 工作表名稱有特殊字元
df = pd.read_excel('data.xlsx', sheet_name='部門(北區)')
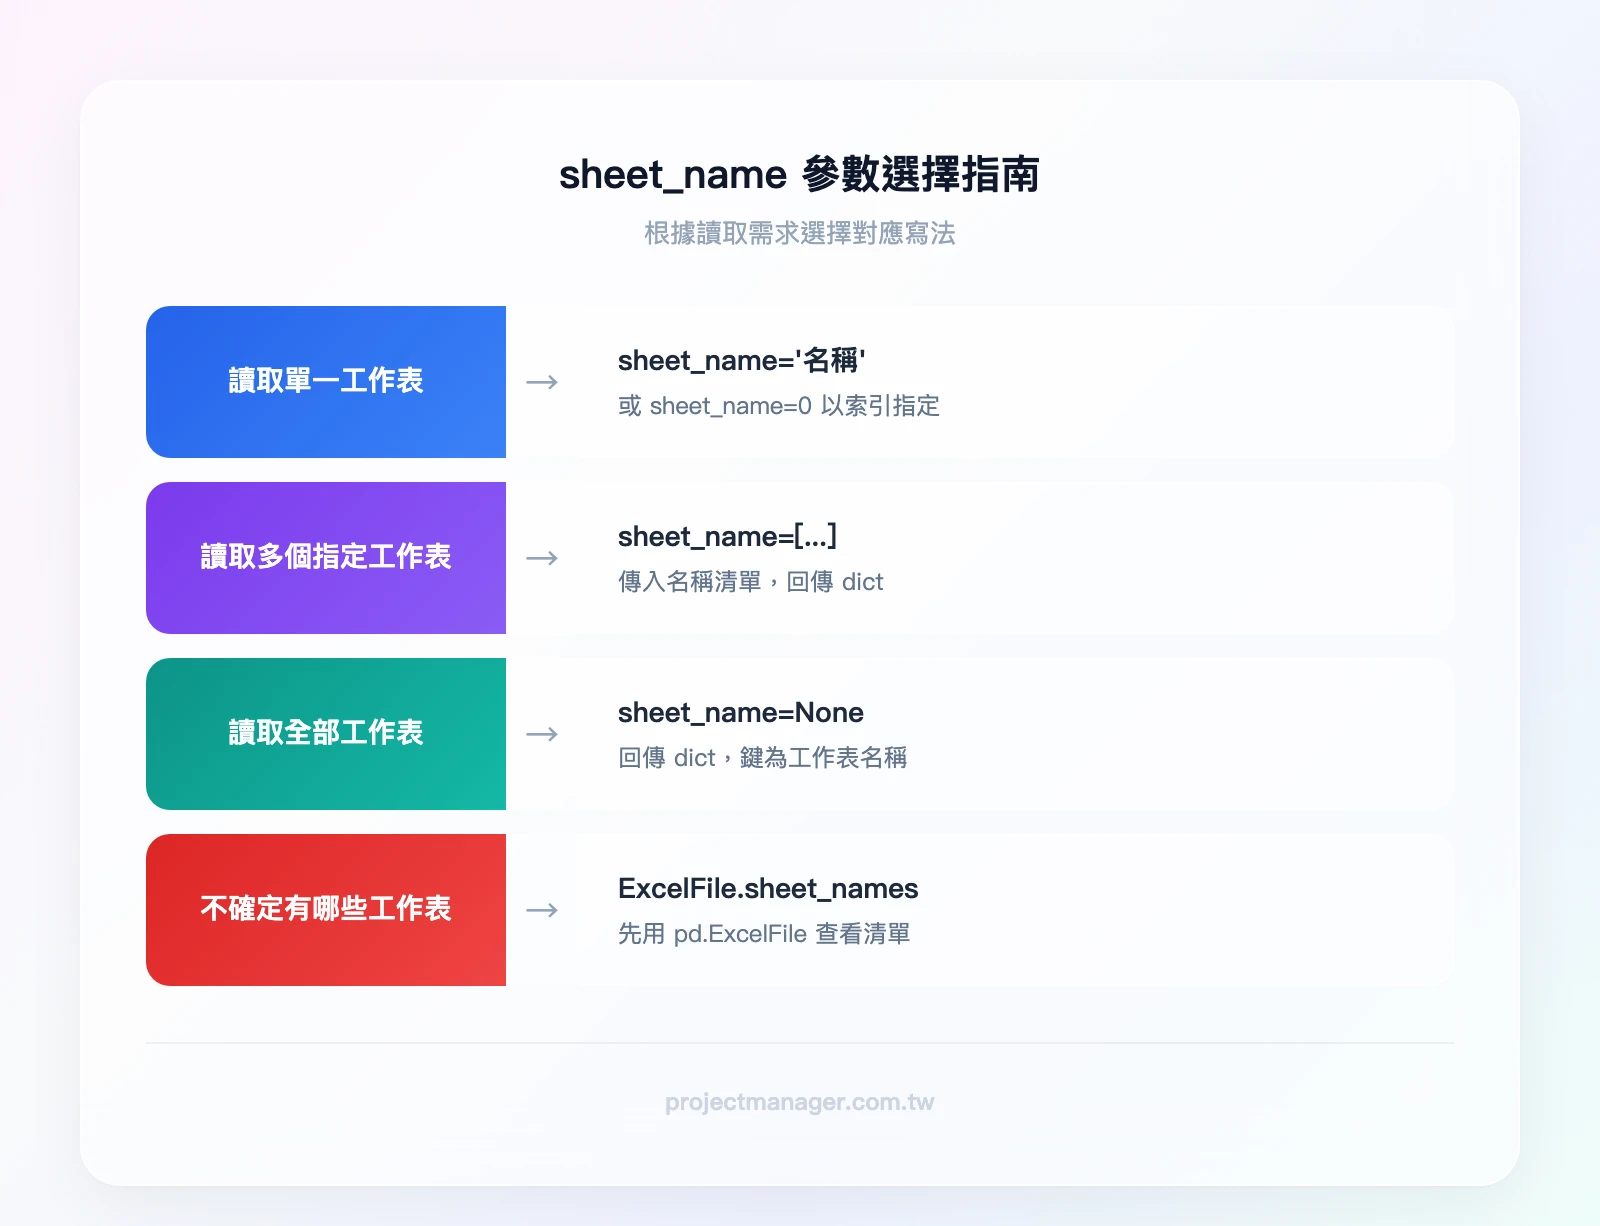
(回傳 dict)、讀取全部工作表→sheet_name=None(回傳 dict)、不確定有哪些工作表→先用 pd.ExcelFile.sheet_names 查看]
engine 參數:如何選對引擎避免 ValueError
engine 參數決定 pandas 用哪個底層套件來解析 Excel 檔案。選錯引擎是 ValueError: Excel file format cannot be determined 的主要原因。
## 明確指定引擎(推薦做法)
df = pd.read_excel('data.xlsx', engine='openpyxl')
df = pd.read_excel('legacy.xls', engine='xlrd')
df = pd.read_excel('data.xlsb', engine='pyxlsb')
df = pd.read_excel('data.ods', engine='odf')
引擎選擇判斷流程:
- 看副檔名:
.xlsx/.xlsm→openpyxl;.xls→xlrd;.xlsb→pyxlsb;.ods→odf - 如果不指定
engine,pandas 會根據副檔名自動選擇。但自動選擇有時會失敗(例如檔案沒有副檔名、或副檔名被改過) - 最佳實踐:永遠明確指定
engine,避免環境差異導致的錯誤
## 完整的防錯寫法
import pandas as pd

file_path = 'report.xlsx'

try:
    df = pd.read_excel(file_path, engine='openpyxl')
except Exception as e:
    print(f"讀取失敗: {e}")
    # 嘗試其他引擎
    df = pd.read_excel(file_path, engine='xlrd')
欄位與行數控制(usecols、skiprows、nrows)
這三個參數讓你只讀取需要的資料,對大檔案效能優化特別重要。
usecols——只讀取特定欄位:
## 以欄位名稱指定
df = pd.read_excel('data.xlsx', usecols=['姓名', '進度', '截止日期'])

## 以 Excel 欄位字母指定(A 欄到 C 欄)
df = pd.read_excel('data.xlsx', usecols='A:C')

## 以欄位索引指定
df = pd.read_excel('data.xlsx', usecols=[0, 2, 4])

## 用函數篩選(只讀取名稱包含「日期」的欄位)
df = pd.read_excel('data.xlsx', usecols=lambda x: '日期' in str(x))
Excel 欄位字母對照: A=第1欄、B=第2欄、C=第3欄…Z=第26欄、AA=第27欄。usecols='A:C' 等同於讀取前三欄。你也可以用不連續的寫法:usecols='A,C,E'。
skiprows——跳過前幾行:
## 跳過前 2 行(常見於報表有標題區塊的情況)
df = pd.read_excel('data.xlsx', skiprows=2)

## 跳過特定行(第 0、2、4 行)
df = pd.read_excel('data.xlsx', skiprows=[0, 2, 4])

## 用函數判斷跳過條件
df = pd.read_excel('data.xlsx', skiprows=lambda x: x in [0, 1])
nrows——只讀取前 N 列資料:
## 只讀取前 100 列(適合先預覽大檔案)
df = pd.read_excel('data.xlsx', nrows=100)
組合技: skiprows + nrows + usecols 可以精確定位 Excel 中的任意區塊。
## 跳過前 3 行標題,只讀取 A 到 D 欄的前 50 筆資料
df = pd.read_excel(
    'data.xlsx',
    skiprows=3,
    nrows=50,
    usecols='A:D'
)
標題列與索引設定(header、index_col)
header——指定標題列位置:
## 預設:第一行為標題(header=0)
df = pd.read_excel('data.xlsx')

## 標題在第三行(從 0 起算)
df = pd.read_excel('data.xlsx', header=2)

## 沒有標題列(pandas 會自動編號 0, 1, 2...)
df = pd.read_excel('data.xlsx', header=None)

## 多層標題(MultiIndex columns)
df = pd.read_excel('data.xlsx', header=[0, 1])
index_col——指定索引欄位:
## 以欄位名稱設定索引
df = pd.read_excel('data.xlsx', index_col='任務ID')

## 以欄位位置設定索引
df = pd.read_excel('data.xlsx', index_col=0)
常見情境: 很多台灣企業的 Excel 報表前面會有 2-3 行的報表標題(例如「XX公司月度營收報表」「報表期間:…」),真正的欄位名稱在第 3 或第 4 行。這時候就需要 header 搭配 skiprows 使用。
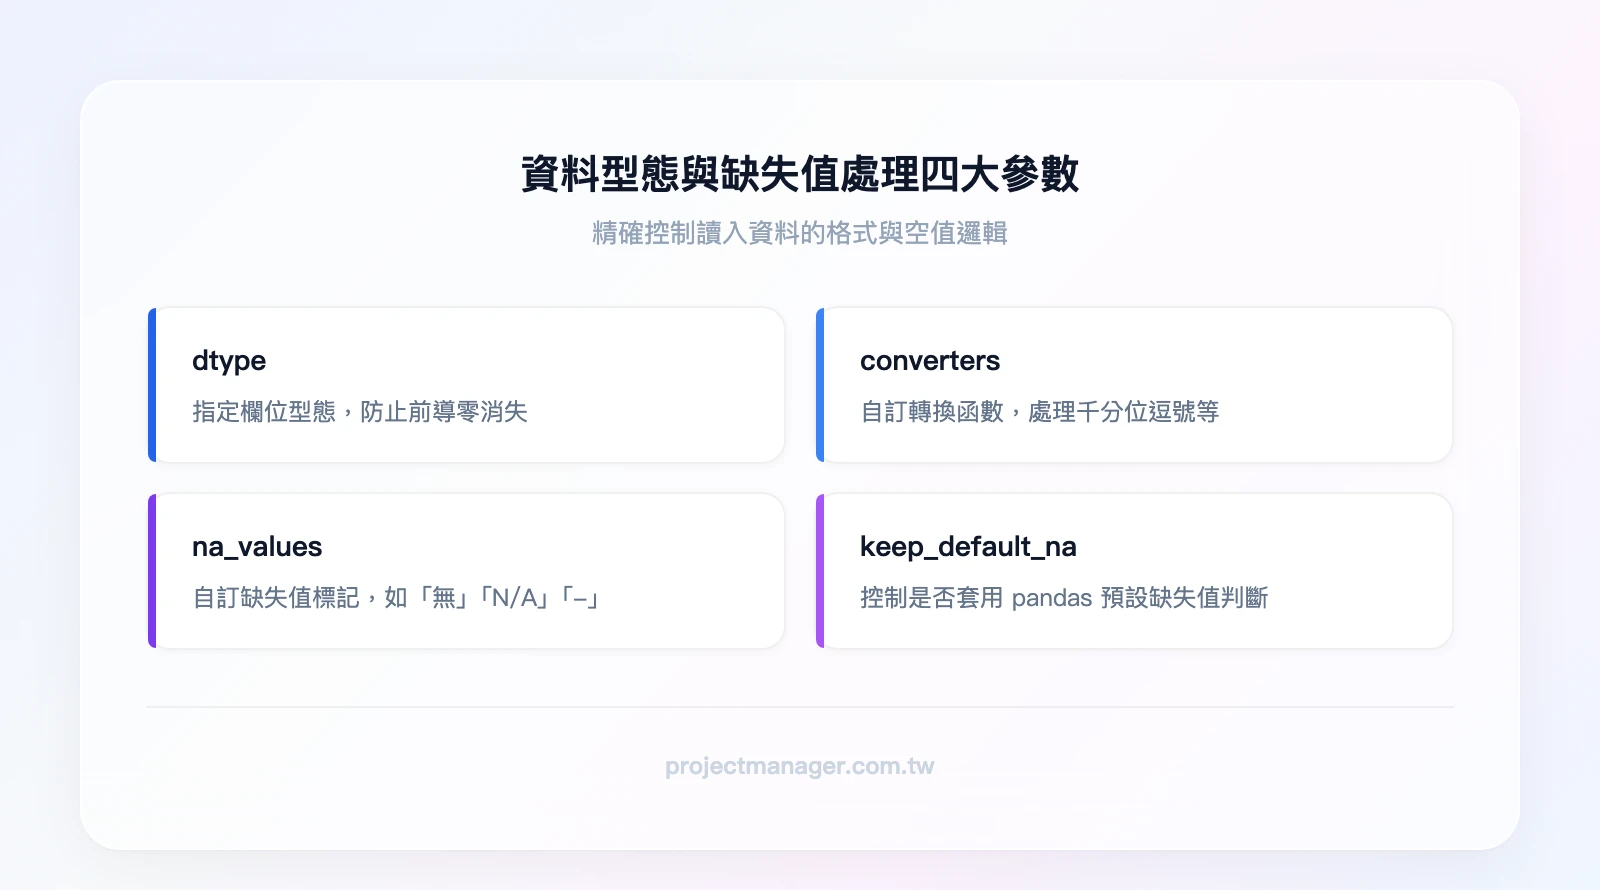
資料型態與缺失值處理(dtype、converters、na_values、keep_default_na)
dtype——指定欄位資料型態:
## 將「員工編號」強制讀為字串(避免前導零被吃掉)
df = pd.read_excel('data.xlsx', dtype={'員工編號': str})

## 多個欄位指定型態
df = pd.read_excel('data.xlsx', dtype={
    '員工編號': str,
    '薪資': float,
    '部門代碼': str
})
為什麼需要 dtype? Excel 中的「001」如果被 pandas 自動判斷為數字,會變成 1,前導零消失。這在處理員工編號、郵遞區號、產品代碼時特別容易出問題。更多 Excel 編碼問題的處理方式可以參考相關教學。
converters——自訂欄位轉換函數:
## 自訂轉換邏輯
df = pd.read_excel('data.xlsx', converters={
    '金額': lambda x: float(str(x).replace(',', '')),  # 移除千分位逗號
    '日期': lambda x: str(x).strip()  # 去除前後空白
})
na_values 與 keep_default_na——缺失值處理:
## 將「無」、「N/A」、「-」視為缺失值
df = pd.read_excel('data.xlsx', na_values=['無', 'N/A', '-', '待確認'])

## 關閉預設缺失值判斷(pandas 預設會將空字串、'NA'、'null' 等視為 NaN)
df = pd.read_excel('data.xlsx', keep_default_na=False)
日期與頁尾處理(parse_dates、skipfooter)
parse_dates——自動解析日期欄位:
## 指定日期欄位
df = pd.read_excel('data.xlsx', parse_dates=['開始日期', '結束日期'])

## 合併多欄為日期(例如「年」「月」「日」三欄合併)
df = pd.read_excel('data.xlsx', parse_dates={'日期': ['年', '月', '日']})
skipfooter——跳過結尾行數:
## 跳過最後 3 行(常見於報表底部有合計列或備註)
df = pd.read_excel('data.xlsx', skipfooter=3, engine='openpyxl')
注意:skipfooter 在某些引擎下的行為可能不同。使用 openpyxl 引擎時最穩定。
pd.read_excel 常見問題 FAQ
為什麼 pd.read_excel 讀不到資料?
最常見的原因有三個:檔案路徑錯誤(用 os.path.exists() 確認)、sheet_name 指定的工作表不存在(用 pd.ExcelFile.sheet_names 查看)、或檔案被其他程式鎖定(關閉 Excel 再試)。如果讀取成功但 DataFrame 是空的,檢查 header 和 skiprows 參數是否跳過了所有資料行。
pd.read_excel 有 encoding 參數嗎?
pd.read_excel 本身沒有 encoding 參數,因為 .xlsx 格式內部使用 UTF-8 編碼,不需要額外指定。如果你遇到中文亂碼,通常是因為檔案實際上是 CSV 格式(只是副檔名被改成 .xlsx),這時應改用 pd.read_csv('file.xlsx', encoding='big5') 或 encoding='utf-8-sig'。更多 Excel 公式與資料處理的技巧也可以參考。
如何處理 Excel 中的合併儲存格?
pandas 會將合併儲存格的值只放在第一個儲存格,其餘填入 NaN。讀取後用 df['欄位名'].ffill() 向下填充即可。如果合併結構太複雜,建議先在 Excel 中取消合併儲存格再另存新檔。
pandas 升級到 2.0 後讀不到 .xlsx 怎麼辦?
安裝 openpyxl(pip install openpyxl)並在程式碼中明確指定 engine='openpyxl'。pandas 2.0 改變了預設引擎的選擇邏輯,不再自動使用 xlrd 讀取 .xlsx。這是一次性的修復,改完後就不會再遇到。
pd.read_excel 和 pd.read_csv 該用哪個?
如果你的資料來源是 Excel 檔案(.xlsx/.xls),用 pd.read_excel。如果是 CSV 檔案,用 pd.read_csv——它的讀取速度比 pd.read_excel 快 5-10 倍,而且支援 encoding 參數處理中文編碼。如果你的 Excel 檔案超過 50MB 且不需要多工作表功能,建議先轉成 CSV 再用 pd.read_csv 讀取。
如何一次讀取 Excel 中的所有工作表?
使用 sheet_name=None 參數:dfs = pd.read_excel('file.xlsx', sheet_name=None)。回傳值是一個字典,鍵為工作表名稱,值為對應的 DataFrame。要合併所有工作表,用 pd.concat(dfs.values(), ignore_index=True)。